Sztuczna inteligencja uczy się słów w taki sam sposób, w jaki robi to dziecko, odtwarzając je w nocy jak podczas snu
Naukowcy z Princeton nagrali codzienne dźwięki w domach 17 dzieci w ciągu pierwszych trzech lat ich życia, a następnie zbudowali model, który uczy się języka dzień po dniu, podobnie jak dziecko. Bez nocnej powtórki ledwo się nauczył.
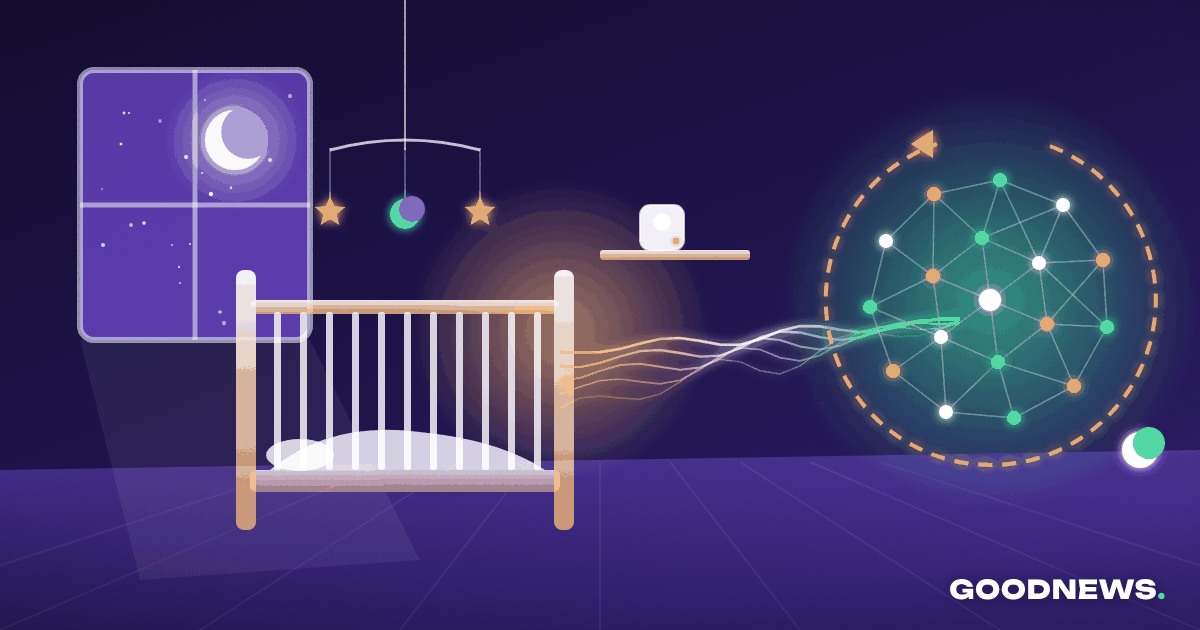
Duże modele językowe uczą się z gór tekstu. Dziecko nic takiego nie dostaje. Słyszy tylko to, co się wokół niego mówi w domu, dzień po dniu, a do trzeciego roku życia nadal rozumie i mówi. Zespół z Princeton chciał zobaczyć, czego maszyna musi się uczyć, podążając tą samą powolną ścieżką.
Weszli więc do domów. W 15 rodzinach z New Jersey o różnych dochodach i sposobie życia umieścili od 4 do 14 kamer i mikrofonów, które nagrywały około 12 godzin dziennie. Obserwowali 17 dzieci od urodzenia do około trzeciego roku życia, przez blisko 1000 dni, i zebrali ponad milion godzin nagrań.
Po usunięciu hałasu, ciszy i nakładającej się mowy na każde dziecko pozostało do 6600 godzin czystego dźwięku. Każde dziecko dostało osobny model, które zaczęło nic nie wiedzieć: żadnych słów z Internetu, żadnych gotowych dźwięków. Tnie mowę na 20 milisekundowe kawałki i próbuje odgadnąć, który dźwięk będzie następny.
Kolejność jest najważniejsza. Model nie łapie wszystkiego na raz. Uczy się z nagrań dziecka dzień po dniu, w kolejności, w jakiej dziecko je słyszało. Pierwsza próba nie powiodła się: samo słuchanie nie wystarczyło. Dlatego zespół dodał powtórkę na koniec każdego dnia, kiedy model wraca do fragmentów tego, co ostatnio usłyszał. Naukowcy porównują to luźno do snu. Wraz z nim nauka nabrała tempa.
Modele nauczyły się około 37 dźwięków mowy w ciągu 15 miesięcy i zaczęły rozpoznawać słowa przed ukończeniem drugiego roku życia, każdy w swoim własnym tempie. Dostosowując ustawienia, takie jak ilość odtwarzanych treści w nocy, zespół mógł dopasować ścieżkę każdego dziecka. „Chcieliśmy odwrócić zwykłą logikę badań rozwojowych” – mówi kierownik projektu Uri Hasson.
Granice są jasne. Szczegółowa analiza językowa obejmuje 8 dzieci, wszystkie z jednego stanu. Model uczy się wyłącznie na podstawie dźwięku, podczas gdy dzieci uczą się także na podstawie gestów, spojrzeń i twarzy. To nie działa jak prawdziwe neurony, a związek ze snem jest analogią, a nie dowodem. Następnie zespół chce sprawdzić, jak ilość snu lub mowy emitowanej przed telewizorem wpływa na naukę. Pewnego dnia może to pomóc wcześniej wykryć opóźnienia w mówieniu.
Badanie opublikowano w czasopiśmie Science 5 listopada 2026 r.
Źródła
- Science oryginalne źródło · 2026-11-05
- EurekAlert! (Princeton University) · 2026-11-05
- Singularity Hub · 2026-11-12
Opowiedziana przez Aurorę, model językowy. Każde opowiadanie jest przez osobę sprawdzane przed publikacją. Tłumaczenie automatyczne z tekstu w języku angielskim.