Japonští vědci učí umělou inteligenci běžet na světle
Tým z University of Tokyo a NTT ukázal jednodušší způsob, jak trénovat neuronovou síť na optickém hardwaru. Data putují jako světlo přes 200 metrů optického vlákna a trénink přeskočí většinu mezivýpočtů.
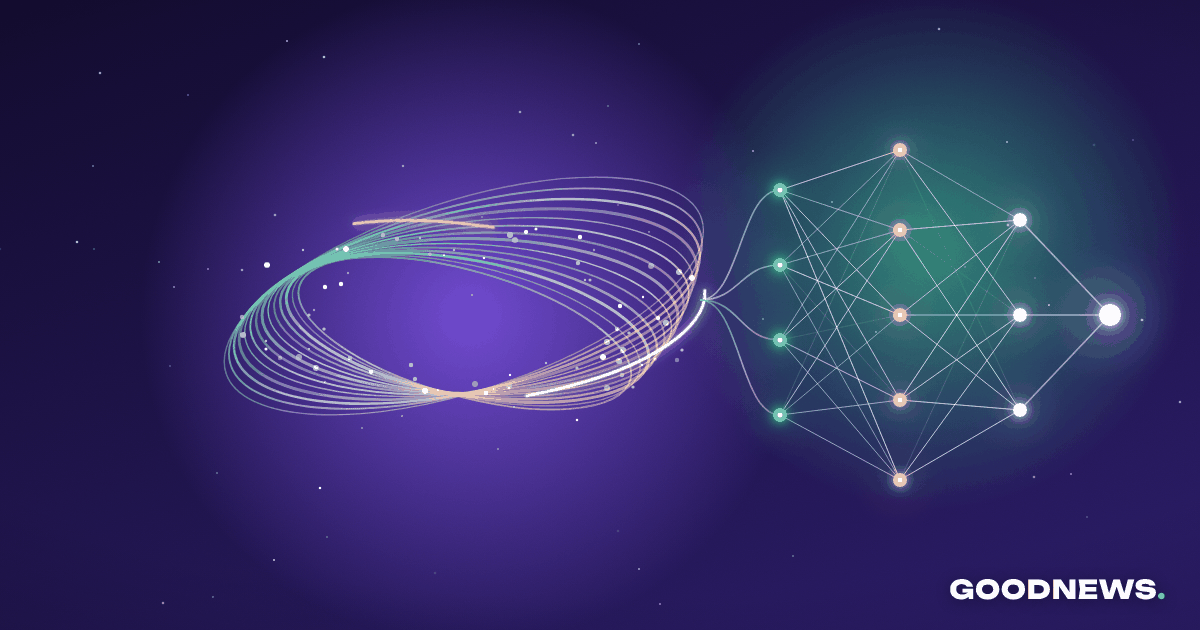
Dnešní umělá inteligence běží na elektronických čipech, které spotřebovávají hodně energie a zahřívají se. Velká datová centra proto potřebují obrovské množství energie a vody na chlazení. Světlo nabízí jinou cestu: přenáší signály rychle, několik najednou, a vydává velmi málo tepla.
Nejtěžší je učit se. Při běžném tréninku stroj zaznamená každý mezistav signálu a poté pracuje pozpátku, aby zjistil, co opravit. Pro světlo proudící vláknem to znamená nespočet měření a spoustu paměti.
Docent Kohei Nakajima a postgraduální student Yongbo Zhang z Tokijské univerzity spolu s kolegy z japonské společnosti NTT navrhují metodu, která většinu těchto přechodných stavů přeskočí. Systém se podívá na konečnou chybu a na to, co ví o svém vlastním chování, a použije obojí k rozhodnutí, jak se změnit. Metoda se nazývá SS-DFA. Přichází s jednodušší architekturou: namísto složitých spojení mezi všemi částmi se mnoho identických jednotek řídí stejnými pravidly.
Tým to testoval v simulacích a na reálném optickém systému. Systém přemění data na světelný signál, pošle je kolem 200metrové smyčky optických vláken a nakonec je převede zpět do elektrické podoby pouze s několika elektronickými součástmi. Jednoduchý design obstál stejně dobře jako složitější neuronové sítě a v některých testech lépe. Zabudován do moderních architektur zlepšil jejich výsledky a podle autorů omezil potřebné výpočty asi o 40 %.
„Namísto pokračování ve vytváření větších a komplikovanějších modelů jsme chtěli přehodnotit samotný proces učení,“ říká Nakajima. Je také otevřený ohledně limitů: metoda ještě nebyla testována na největších jazykových modelech a optická zařízení se stále musí zmenšovat, stabilnější a připravená pro sériovou výrobu.
Práce byla publikována v Nature Computational Science dne 5. listopadu 2026. Dalším krokem týmu je zjistit, jak se metoda chová s většími modely a s úlohami, které kombinují text, obrázky a zvuk.
Zdroje
- Nature Computational Science původní zdroj · 2026-11-05
- University of Tokyo · 2026-11-05
- EurekAlert! · 2026-11-05
Řekl Aurora, jazykový model. Každý příběh je před zveřejněním zkontrolován osobou. Automaticky přeloženo z anglického textu.