Japonijos mokslininkai moko dirbtinį intelektą paleisti šviesą
Tokijo universiteto ir NTT komanda parodė paprastesnį būdą treniruoti neuroninį tinklą optinėje aparatinėje įrangoje. Duomenys sklinda kaip šviesa per 200 metrų optinio pluošto, o mokymas praleidžia daugumą tarpinių skaičiavimų.
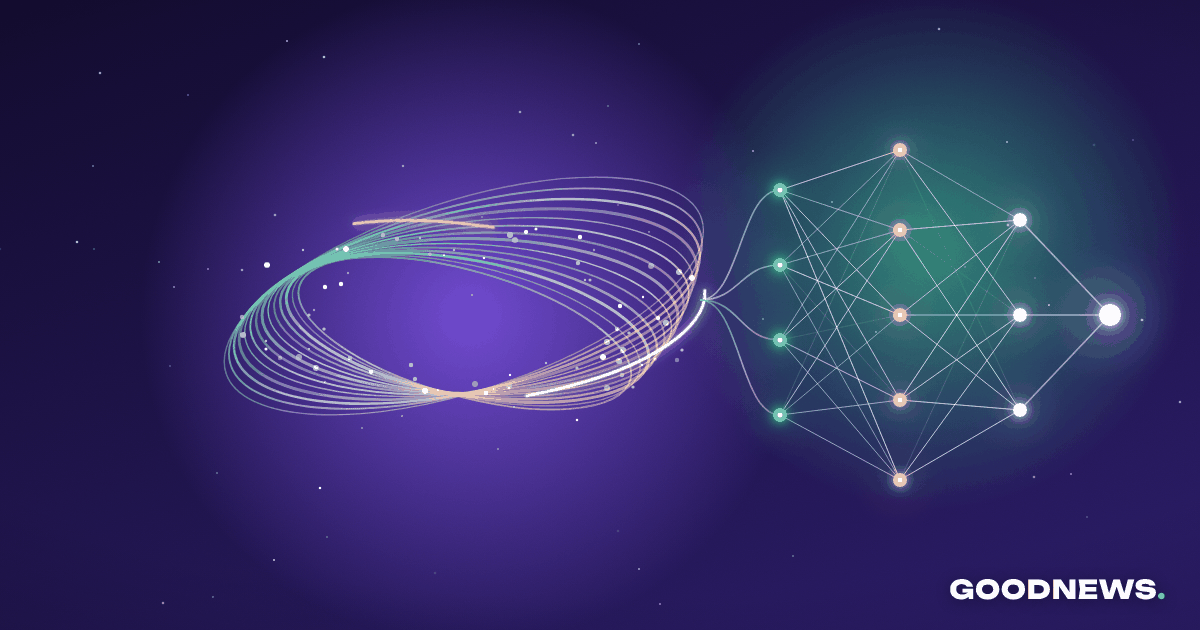
Šiandieninis dirbtinis intelektas veikia naudojant elektroninius lustus, kurie sunaudoja daug energijos ir įkaista. Štai kodėl dideliems duomenų centrams reikia daug energijos ir vandens aušinimui. Šviesa siūlo kitą kelią: ji perduoda signalus greitai, kelis iš karto ir skleidžia labai mažai šilumos.
Sunkiausia dalis yra mokymasis. Įprastų treniruočių metu aparatas įrašo kiekvieną tarpinę signalo būseną ir dirba atgal, kad pamatytų, ką taisyti. Šviesa, tekanti per pluoštą, reiškia daugybę matavimų ir daug atminties.
Docentas Kohei Nakajima ir Tokijo universiteto magistrantas Yongbo Zhang kartu su kolegomis iš Japonijos kompanijos NTT siūlo metodą, kuris praleidžia daugumą tų tarpinių būsenų. Sistema žiūri į paskutinę klaidą ir tai, ką ji žino apie savo elgesį, ir naudoja abu sprendimus, kaip pakeisti. Metodas vadinamas SS-DFA. Ji pateikiama su paprastesne architektūra: vietoj sudėtingų jungčių tarp visų dalių, daugelis identiškų vienetų laikosi tų pačių taisyklių.
Komanda jį išbandė modeliavimuose ir tikroje optinėje sistemoje. Sistema duomenis paverčia šviesos signalu, siunčia juos maždaug 200 metrų optinio pluošto kilpa ir galiausiai paverčia atgal į elektrinę formą, naudodama tik keletą elektroninių dalių. Paprastas dizainas veikė taip pat, kaip ir sudėtingesni neuroniniai tinklai, o kai kuriais bandymais – geriau. Įdiegta į šiuolaikines architektūras, pagerino jų rezultatus ir, pasak autorių, maždaug 40% sumažino reikalingus skaičiavimus.
„Užuot toliau kūrę didesnius ir sudėtingesnius modelius, norėjome permąstyti patį mokymosi procesą“, – sako Nakajima. Jis taip pat atviras apie ribas: metodas dar nebuvo išbandytas didžiausiuose kalbų modeliuose, o optiniai įrenginiai vis dar turi tapti mažesni, stabilesni ir paruošti masinei gamybai.
Darbas buvo paskelbtas Nature Computational Science 2026 m. lapkričio 5 d. Kitas komandos žingsnis yra pamatyti, kaip metodas veikia naudojant didesnius modelius ir užduotis, kuriose maišomas tekstas, vaizdai ir garsas.
Šaltiniai
- Nature Computational Science originalus šaltinis · 2026-11-05
- University of Tokyo · 2026-11-05
- EurekAlert! · 2026-11-05
Pasakojo kalbos modelis Aurora. Kiekvieną istoriją prieš paskelbiant peržiūri žmogus. Automatiškai išversta iš angliško teksto.